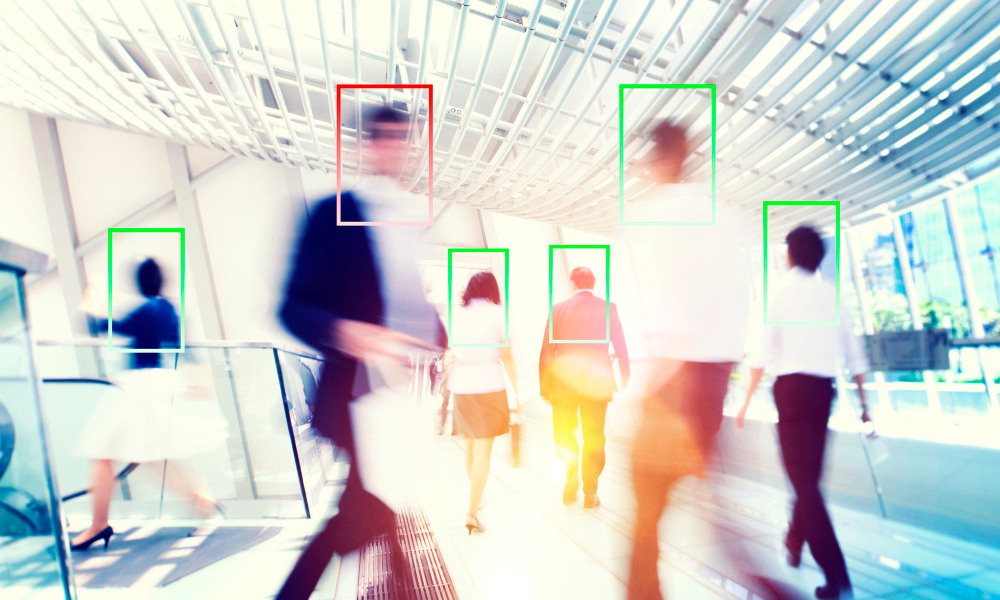
SF映画では、コンピュータが視界に入った物体を瞬時に認識するシーンがよく描かれますが、そうした技術はすでに現実のものとなっています。この技術は、自動運転車からセキュリティシステムに至るまで、あらゆる分野に変革をもたらしています。こうした「視覚」に関する技術革命の中核を担っているのが、現代において最も影響力のある物体検出フレームワークの一つ、「YOLO(You Only Look Once)」です。
YOLOを活用すれば、単なるウェブカメラを「知的な監視役」へと変貌させ、徘徊する鹿と近所の犬をミリ秒単位で識別させることさえ可能になります。本ガイドでは、YOLOの技術的な基礎に加え、その理論や実際の活用事例に至るまで、この技術のすべてを詳しく解説します。
YOLO物体検出とは何ですか?
2015年に登場したYOLOは、従来の物体検出のあり方を一変させました。それ以前の手法は、スライドウィンドウを用いて画像を繰り返し走査するという手間のかかる(そして極めて低速な)ものでしたが、YOLOはそれらとは一線を画す、より洗練されたアプローチを採用しています。
具体的には、画像をグリッド状に分割し、ニューラルネットワークによる一度の順伝播(フォワードパス)で、バウンディングボックスとクラス確率を同時に予測します。この「シングルショット」型のアーキテクチャにより、リアルタイム検出を可能にする、毎秒45〜155フレームという驚異的な処理速度を実現しています。
その成功の鍵は、畳み込みニューラルネットワーク(CNN)のバックボーン(一般的にはDarknetが使用されます)と、アンカーベースの予測システムにあります。自動運転車での歩行者検知や小売店の棚にある商品のカウントなど、予測不可能な現実世界におけるタスクにおいて、YOLOは他の特化型アルゴリズムの追随を許さない能力を発揮します。
YOLOのアーキテクチャについて
YOLOのアーキテクチャは、生のピクセルデータを実用的な予測に変換する計算層がサンドイッチ状に重なった構造になっています。特徴抽出器として機能するバックボーン(通常はDarknetの派生型)は、入力画像を畳み込み層を通して処理し、視覚情報を段階的に抽象化していきます。
これらの特徴はネック(FPNやPANetなどのコンポーネントで構成されることが多い)に入力され、ネットワークが様々なサイズの物体を処理できるように特徴ピラミッドを形成します。小さな物体を見逃してしまう初期の物体検出器の苦労を覚えているでしょうか?このマルチスケールアプローチこそが、その悩みを最終的に解決したのです。
YOLOによる物体検出の仕組みとは?
その画期的な動作原理は、グリッド(格子)ベースの検出手法にあります。入力画像をS×Sのグリッド(YOLOv3では通常13×13)に分割した後、アルゴリズムは各セルに対し、その境界内に中心がある物体を特定する役割を割り当てます。
あらゆる候補領域を徹底的に探索するのではなく、各グリッドセルにおいてB個のバウンディングボックスを予測します。各ボックスは、x・y座標、幅、高さ、そして信頼度スコア(confidence score)という5つの要素で構成されます。この信頼度は、ボックス寸法の精度と、そこに物体が存在する確率の両方を示しています。
同時に、各グリッドセルは条件付きクラス確率(Pr(Class|Object))を予測します。これは、「何かがそこに存在すると仮定した場合、それは具体的に何なのか?」という重要な問いに答えるものです。予測処理全体は単一の「フォワードパス(順伝播)」で行われます。これは、2段階検出器(two-stage detector)が必要とするマラソンのような長大な処理とは対照的な、計算上の「スプリント(短距離走)」と言えるものです。
座標誤差、寸法誤差、信頼度誤差、および分類誤差に対して同時にペナルティを課す、多要素からなる損失関数が使用されます。ネットワークは、数千枚の画像を用いた誤差逆伝播法(バックプロパゲーション)を通じて、これら相反する目的のバランスを取るように学習します。最後に、Non-Max Suppression(NMS:非最大値抑制)が処理の仕上げを行い、信頼度スコアの低いボックスを抑制・排除することで、重複する不要なボックスを取り除きます。
実社会での応用
自動運転車:テスラやウェイモ(Waymo)をはじめとする自動運転の先駆的企業は、その派生技術を活用し、交通標識、車両、歩行者をミリ秒単位の遅延で認識しています。このアルゴリズムは、LiDARとカメラの融合データをリアルタイムで解析できるため、走行中の安全に関わる重要な判断を下す上で不可欠なものとなっています。
小売業の分析:今日の主要な店舗に足を踏み入れると、YOLOベースのシステムが密かに在庫をカウントし、買い物客の店内での動線を追跡し、マーケティングチームが重視するヒートマップを生成しています。特に店長たちに評価されているのは、従来のカメラでは実現が難しかった「人の絶え間ない監視なしに、万引きなどの不正行為の兆候を捉える」という点です。
野生生物の保護:生態学者は、ドローン映像やトレイルカメラ(自動撮影カメラ)を活用し、広大な自然環境下で絶滅危惧種を監視するためにこのシステムを導入しています。適切に学習させたアルゴリズムは誤検知率が低く、かつては完了までに数千時間もの人手を要した個体数調査に革命をもたらしました。
製造業の品質管理:工場の生産ラインでは、マイクロチップから自動車部品に至るまで、あらゆる製品の欠陥を人間の検査員には不可能な速度で発見するために、こうした検出システムが組み込まれています。専用のエッジコンピューティングデバイスで動作するため、高コストな集中処理を必要とせず、分散型の検査体制を構築することが可能です。
結論
Transformerアーキテクチャや自己教師あり学習が、YOLOの効率的な設計思想と融合し続ける中、私たちは機械が単に物体を検知する段階を超え、新たな転換点を迎えようとしています。機械は視覚的なシーンにおいて、要素間の関連性や文脈、そして意図までも学習するようになるでしょう。
計算リソースの制約は急速に解消されつつあります。スマートフォンから人工衛星に至るまで、より新しく軽量なYOLOの派生モデルが動作するようになった今、私たちは、ほんの10年前にはSFの世界の話だと思われていたコンピュータビジョン技術の「民主化」を目の当たりにしています。かつては単に「猫」を識別するだけで私たちを驚かせたアルゴリズムが、近い将来、その猫が次に何をしようとしているのかを正確に理解するようになるかもしれません。